


 컨텐츠








최근 인공지능(AI) 기술은 상상을 뛰어넘는 속도로 발전하고 있습니다.
하지만 AI 산업이 커질수록 새로운 문제가 등장하고 있습니다.
바로 막대한 인프라 비용과 전력 소비입니다.
AI 모델이 점점 커지면서 더 많은 데이터를 학습해야 하고, 이를 처리하기 위해서는 엄청난 연산 능력이 필요합니다. 문제는 성능을 높일수록 데이터센터 구축 비용과 전기 사용량도 함께 증가한다는 점입니다.
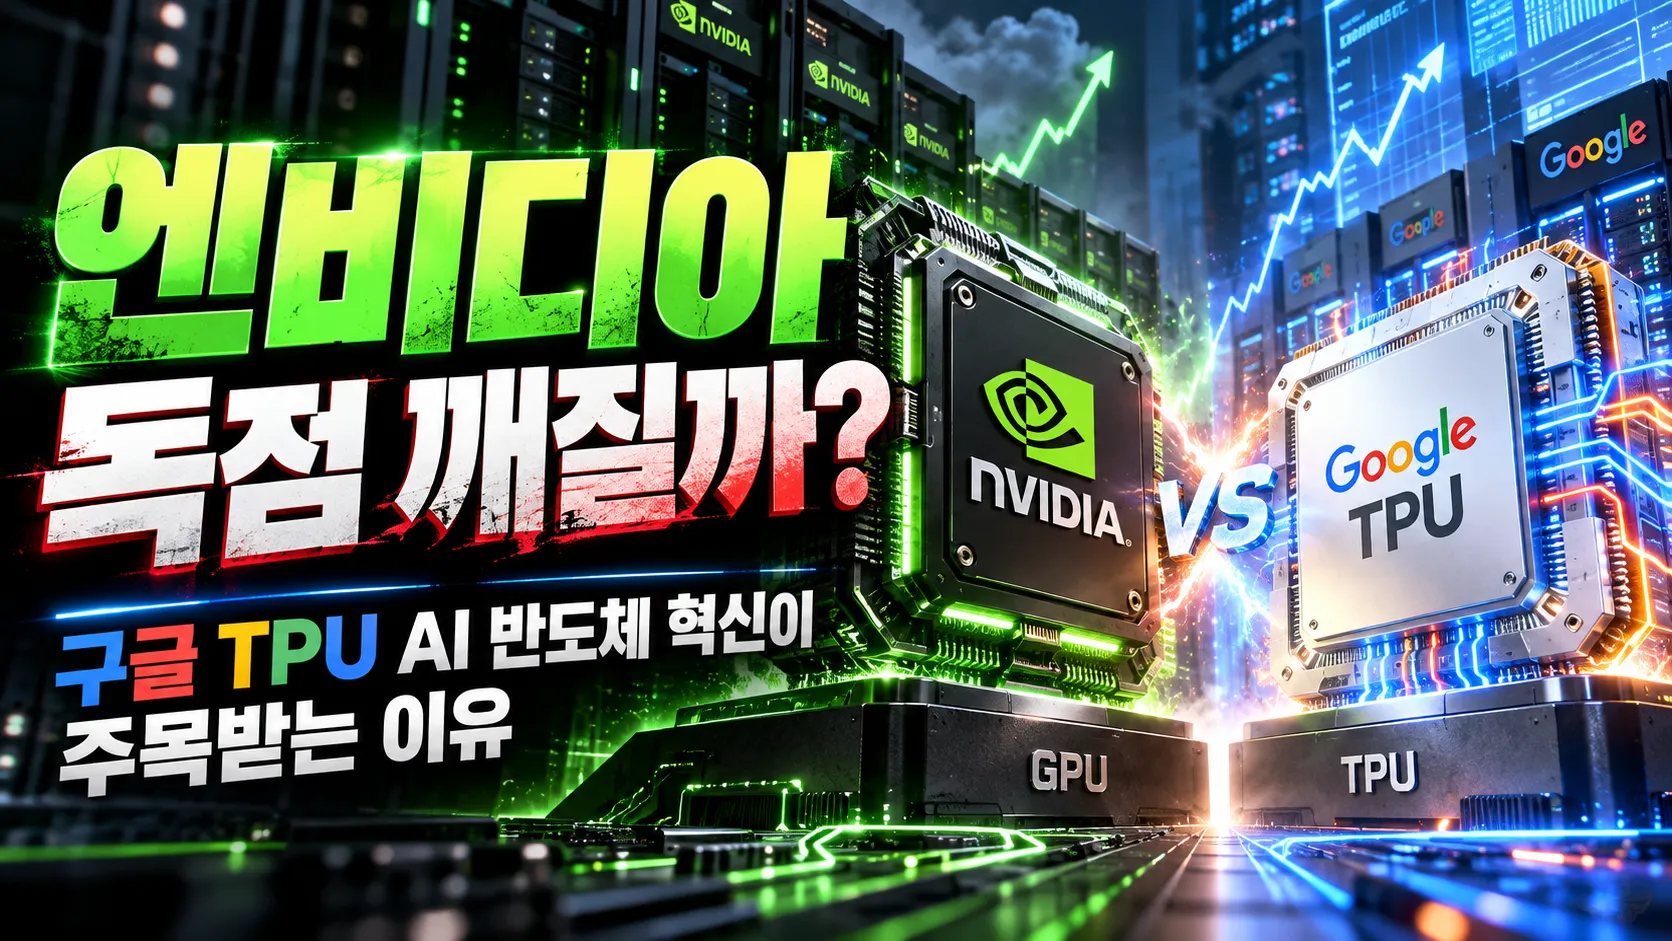
이런 상황에서 등장한 것이 바로 구글 TPU입니다.
구글 TPU는 단순히 더 빠른 반도체가 아닙니다.
AI 시대에 맞춰 설계된 전용 칩으로, 기업들이 AI 서비스를 더 효율적으로 운영할 수 있도록 비용 구조 자체를 바꾸는 핵심 기술로 평가받고 있습니다.
이번 글에서는 구글 TPU가 어떻게 만들어졌는지, 어떤 기술을 활용하는지, 그리고 엔비디아 GPU와 어떤 차이가 있는지 알아보겠습니다.
구글 TPU의 탄생
GPU의 한계를 넘기 위해 만들어진 AI 전용 반도체
과거 AI 연구와 데이터센터 연산은 대부분 엔비디아 GPU가 담당했습니다.
GPU는 원래 게임이나 영상 그래픽 처리를 위해 개발된 반도체입니다.
수많은 데이터를 동시에 처리할 수 있다는 장점 덕분에 AI 학습에도 활용되기 시작했지만, 본래 목적이 그래픽 처리였기 때문에 딥러닝 연산에서는 불필요한 부분도 존재했습니다.
GPU 안에는 다양한 명령어 처리 장치와 복잡한 제어 구조가 포함되어 있습니다.
하지만 AI 모델이 필요로 하는 핵심 연산은 대부분 행렬 계산입니다.
구글은 이 점에 주목했습니다.
"AI 연산만을 위해 설계된 칩을 만들면 어떨까?"
이런 생각에서 탄생한 것이 TPU(Tensor Processing Unit)입니다.
TPU는 범용성을 줄이고 인공지능 모델 학습과 추론에 필요한 텐서 연산에 집중하도록 설계된 ASIC(주문형 반도체)입니다.
불필요한 기능을 줄이고 AI 연산에 필요한 구조를 최대한 밀집시키면서 같은 전력으로 더 높은 연산 효율을 낼 수 있도록 만든 것입니다.
결국 TPU의 핵심은 "모든 것을 할 수 있는 칩"이 아니라 "AI만 잘하는 칩"이라는 점입니다.
시스톨릭 어레이와 혼합 정밀도 기술
TPU 성능을 끌어올리는 핵심 구조
구글 TPU의 가장 중요한 기술 중 하나는 시스톨릭 어레이(Systolic Array) 구조입니다.
일반적인 프로세서는 데이터를 계산할 때마다 메모리에서 데이터를 가져오고, 계산한 뒤 다시 저장하는 과정을 반복합니다.
하지만 AI 연산에서는 이런 데이터 이동 과정이 큰 병목이 됩니다.
데이터를 옮기는 과정에서 시간이 지연되고, 전력도 많이 소비되기 때문입니다.
TPU는 이 문제를 해결하기 위해 데이터를 연산 장치 사이에서 직접 이동시키는 구조를 사용합니다.
마치 심장이 혈액을 계속 순환시키는 것처럼 데이터가 여러 연산 유닛을 따라 흐르면서 연속적으로 계산됩니다.
이를 통해 메모리 접근 횟수를 크게 줄이고, 더 빠르고 효율적인 AI 연산이 가능해집니다.
또 하나의 중요한 기술은 혼합 정밀도(Mixed Precision) 연산입니다.
AI 모델은 모든 계산에서 최고 수준의 정밀도가 필요한 것은 아닙니다.
구글은 bfloat16, FP8, INT8 같은 저정밀도 연산 방식을 활용해 필요한 수준의 정확도는 유지하면서 처리 속도와 전력 효율을 높였습니다.
특히 최신 세대 TPU인 트릴리움(Trillium, TPU v6e)은 이전 세대 대비 연산 성능과 전력 효율을 크게 개선하며 대규모 AI 모델 환경에서 경쟁력을 보여주고 있습니다.
TPU Pod와 고속 연결 기술
수만 개의 칩을 하나처럼 움직이는 구조
현재의 초거대 AI 모델은 하나의 반도체만으로 운영할 수 없습니다.
수천 개, 많게는 수만 개의 AI 가속기가 동시에 연결되어 하나의 거대한 컴퓨터처럼 작동해야 합니다.
구글은 이를 위해 TPU Pod라는 대규모 AI 컴퓨팅 클러스터 시스템을 구축했습니다.
일반적인 데이터센터는 네트워크 장비를 통해 여러 칩을 연결하지만, 구글은 자체 개발한 고속 연결 기술을 활용했습니다.
대표적인 기술이 ICI(Interchip Interconnect)와 광학 회로 스위칭(OCS)입니다.
이를 통해 TPU 칩끼리 매우 빠르게 데이터를 주고받을 수 있습니다.
이 구조의 장점은 명확합니다.
첫째, 데이터 이동 지연 시간을 줄일 수 있습니다.
수많은 TPU가 연결되어도 데이터 병목 현상을 최소화할 수 있습니다.
둘째, 규모를 키워도 효율이 크게 떨어지지 않습니다.
AI 모델이 커질수록 필요한 연산량도 증가하는데, TPU Pod는 대규모 확장에 적합하도록 설계됐습니다.
셋째, 데이터센터 운영 비용을 낮출 수 있습니다.
전력 소비와 서버 공간을 줄이면 장기적으로 기업의 총 운영 비용(TCO)을 낮출 수 있습니다.
이런 구조 덕분에 구글은 제미나이(Gemini) 같은 대규모 AI 모델을 안정적으로 학습하고 서비스할 수 있는 기반을 확보했습니다.
구글 TPU와 엔비디아 GPU의 차이
AI 반도체 시장에서 가장 큰 관심을 받는 비교 대상은 구글 TPU와 엔비디아 GPU입니다.
두 제품은 목적 자체가 다릅니다.
엔비디아 GPU는 다양한 작업을 수행할 수 있는 범용 AI 가속기입니다.
그래픽 처리부터 다양한 연구, AI 개발까지 폭넓게 활용할 수 있다는 장점이 있습니다.
반면 구글 TPU는 AI 연산에 최적화된 전용 반도체입니다.
딥러닝의 핵심인 텐서 연산 처리에 집중하기 때문에 특정 AI 작업에서는 높은 효율을 기대할 수 있습니다.
엔비디아 GPU는 CUDA라는 강력한 소프트웨어 생태계를 기반으로 전 세계 개발자와 기업들이 폭넓게 사용하고 있습니다.
반면 TPU는 구글 클라우드(GCP) 환경과 XLA, JAX 같은 구글 중심의 AI 개발 환경에서 강점을 보입니다.
결국 두 기술의 차이는 "범용성"과 "효율성"의 차이라고 볼 수 있습니다.
AI 연구 초기 단계에서는 다양한 실험과 개발이 가능한 GPU가 유리할 수 있습니다.
하지만 하나의 AI 모델이 완성되고, 수많은 사용자가 매일 사용하는 서비스 단계에서는 이야기가 달라집니다.
이때 기업에게 중요한 것은 단순한 최고 성능보다 전력 비용, 서버 운영비, 서비스 유지 비용입니다.
바로 이 지점에서 TPU의 높은 효율성이 경쟁력으로 작용합니다.
앞으로의 AI 반도체 경쟁
칩에서 데이터센터 생태계 경쟁으로 확대
앞으로의 AI 반도체 경쟁은 단순히 어떤 칩이 더 빠른지를 비교하는 싸움이 아닙니다.
반도체 성능뿐 아니라 연결 기술, 데이터센터 설계, 냉각 시스템, 전력 관리, 소프트웨어까지 모두 결합된 종합 경쟁이 되고 있습니다.
구글이 TPU를 개발한 이유도 여기에 있습니다.
AI 서비스를 운영하는 기업 입장에서 중요한 것은 최고 성능의 칩을 확보하는 것만이 아닙니다.
얼마나 낮은 비용으로 안정적인 AI 서비스를 제공할 수 있는지가 핵심 경쟁력이 되고 있습니다.
이 때문에 최근에는 오픈AI, 메타, 마이크로소프트 등 주요 빅테크 기업들도 자체 AI 반도체 개발에 관심을 보이고 있습니다.
엔비디아 의존도를 낮추고, 자신들의 AI 서비스 구조에 최적화된 칩을 확보하려는 움직임입니다.
AI 시대가 본격적인 수익화 단계로 넘어가면서 연산 비용과 인프라 효율성은 기업 경쟁력을 결정하는 중요한 요소가 되고 있습니다.
구글 TPU가 보여준 방향성은 앞으로 AI 산업이 어떤 방식으로 발전할지를 보여주는 중요한 사례라고 할 수 있습니다.
AI 경쟁의 핵심은 이제 단순히 "더 강한 칩"이 아니라 "더 효율적으로 AI를 운영할 수 있는 시스템"으로 이동하고 있습니다.









